Wie KI lernt – Daten und Training
In Folge 4 hast du gelernt, dass das Training die sprichwörtliche „Kochschule“ der KI ist. Doch wie wird aus Millionen von gewöhnlichen Texten, Fotos oder Tabellen eigentlich ein System, das dir auf Knopfdruck komplexe Fragen beantwortet, Gedichte verfasst oder Programmierfehler aufspürt? Warum spricht man dabei von „neuronalen Netzen“, warum durchlaufen moderne Sprachmodelle zwei völlig unterschiedliche Ausbildungsphasen – und warum entscheidet die Güte der Trainingsdaten über Genie oder Scheitern einer KI? In dieser Folge blicken wir verständlich in den Maschinenraum des Lernens.
Du verstehst, wie ein KI-Modell aus Beispielen lernt, warum moderne Sprachmodelle zwei getrennte Trainingsphasen (Pre-Training und Alignment) durchlaufen und warum Datenqualität, Verzerrungen (Bias) und die Wissensgrenze (Knowledge Cutoff) deinen praktischen Alltag mit KI bestimmen.
Klassische Programme vs. Maschinelles Lernen: Rezepte oder Geschmack?
Um zu verstehen, was maschinelles Lernen so revolutionär macht, hilft ein einfacher Vergleich mit klassischer Software:
- Klassische Software (Das starre Kochbuch): Früher musste eine Programmiererin jeden einzelnen Schritt penibel im Voraus festlegen: „Wenn der Nutzer auf Knopf A drückt, dann rechne Wert B plus C und zeige das Ergebnis an.“ Fehlt eine Regel für einen Spezialfall, bricht das Programm ab oder stürzt ab.
- Künstliche Intelligenz (Die Geschmacksschulung): Beim maschinellen Lernen schreibt niemand mehr feste Verhaltensregeln von Hand. Stattdessen füttert man das System mit riesigen Datenmengen – Millionen von Beispielen – und lässt einen mathematischen Algorithmus selbst herausfinden, welche Gesetzmäßigkeiten und Muster darin verborgen liegen.
Möchte man einer klassischen Software beibringen, eine Katze auf einem Foto zu erkennen, müsste man endlose Wenn-Dann-Regeln schreiben: „Hat zwei spitze Ohren, Schnurrhaare und vier Beine.“ Das scheitert sofort, wenn die Katze von hinten zu sehen ist, im Schatten liegt oder sich im Wäschekorb zusammenrollt. Eine KI hingegen bekommt 100.000 Katzenfotos und 100.000 Nicht-Katzen-Fotos vorgesetzt. Sie findet die subtilen visuellen Merkmale ganz von allein.
Die drei Grundschritte des Lernens
Jedes System des maschinellen Lernens folgt im Kern demselben zyklischen Ablauf:
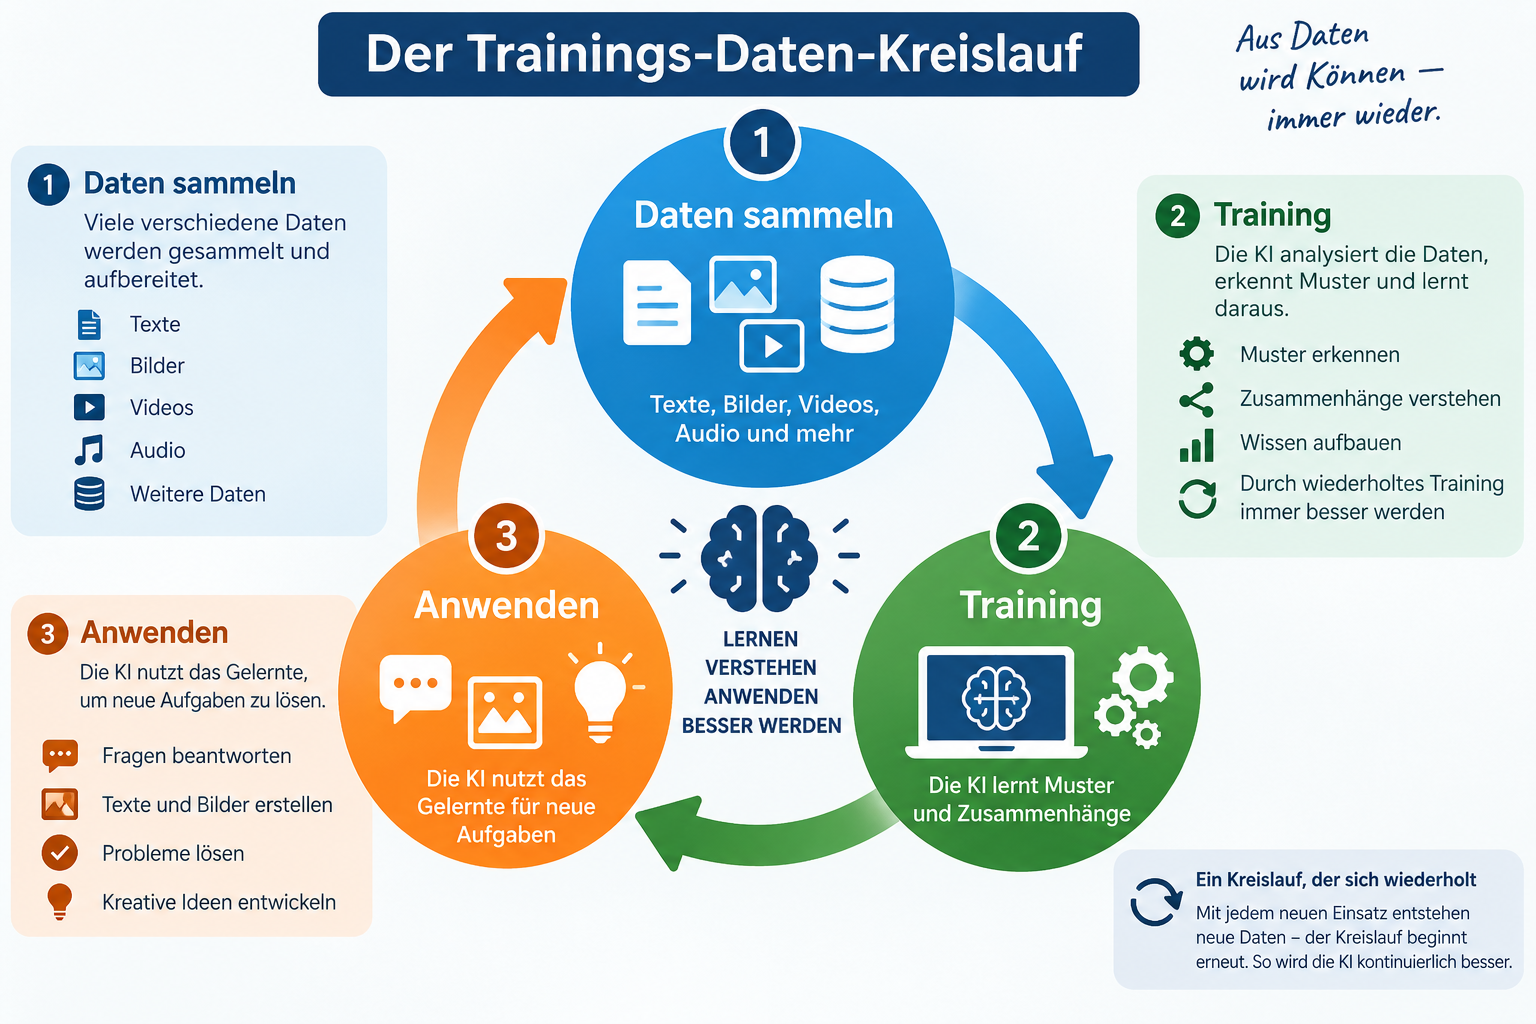
- 1. Daten sammeln (Der Rohstoff): Texte, Bücher, Internetforen, Tabellen oder Fotos werden in gigantischen Mengen zusammengetragen, bereinigt und aufbereitet. Ohne Daten kann keine KI lernen.
- 2. Training (Die Musterberechnung): Das Modell macht Vorhersagen und vergleicht sie mit der Wirklichkeit. Lag es falsch, korrigiert eine mathematische Formel die internen Stellschrauben – die in Folge 4 vorgestellten Parameter. Dieser Rechenschritt wird viele Milliarden Male wiederholt.
- 3. Anwenden / Inferenz (Der Praxiseinsatz): Das fertig trainierte Modell wird für neue, ihm bisher völlig unbekannte Aufgaben eingesetzt. Wenn du heute eine Frage in einen Chatbot tippst, wendet das Modell sein gelerntes Wissen blitzschnell an.
Was sind Neuronale Netze und Deep Learning?
Die mathematische Struktur, in der dieses Wissen gespeichert wird, nennt man künstliches neuronales Netz. Der Name klingt biologisch, gemeint ist aber eine reine Rechenarchitektur:
Neuronales Netz
In einfacher Sprache: Ein digitales Geflecht aus unzähligen kleinen Rechenknoten, das lose dem Zusammenspiel biologischer Nervenzellen im Gehirn nachempfunden ist.
Ein mathematisches System, bei dem Informationen durch Schichten miteinander verbundener Knoten (Neuronen) fließen. Jede Verbindung besitzt eine mathematische Stärke – ein Verbindungsgewicht bzw. einen Parameter. Beim Lernen werden diese Gewichte milliardenfach so feinjustiert, dass das Netz komplexe Muster in Sprache, Ton oder Bild zielsicher erkennt.
Warum spricht die Fachwelt überall von Deep Learning („Tiefem Lernen“)? Der Begriff meint schlicht, dass das neuronale Netz aus sehr vielen hintereinandergeschalteten Schichten besteht:
Deep Learning (Tiefes Lernen)
In einfacher Sprache: Das schichtweise Verarbeiten und Erkennen von Mustern – von winzigen Details bis zum großen Ganzen.
Ein Teilbereich des maschinellen Lernens, bei dem neuronale Netze dutzende oder hunderte aufeinander aufbauende Schichten nutzen. Jede Schicht zieht eine höhere Abstraktionsebene aus den Daten: Beim Betrachten eines Fotos erkennt die erste Schicht nur Hell-Dunkel-Kanten, die nächste Schicht Linien und Ecken, darüber liegende Schichten erkennen Konturen von Augen und Schnurrhaaren – und die letzte Schicht folgert treffsicher: „Das ist eine Katze“.
Wie moderne Sprach-KIs trainiert werden: Die zwei Ausbildungsphasen
Wenn du moderne Chatbots wie ChatGPT, Claude, Gemini oder Le Chat benutzt, erlebst du ein hochentwickeltes Sprachmodell. Ein solches Modell entsteht heute nicht in einem einzigen Durchgang, sondern durchläuft zwei grundlegend verschiedene Ausbildungsphasen:
1. Pre-Training (Das riesige Grundstudium)
In einfacher Sprache: Die monatelange Grundausbildung eines Modells an gigantischen Textmengen aus dem weltweiten Internet.
Die erste, enorm rechenintensive Trainingsphase. Das Modell liest Billionen von Wörtern aus digitalisierten Büchern, Wikipedia-Artikeln, Zeitungen, wissenschaftlichen Arbeiten und Programmcode. Seine einzige Aufgabe lautet: Verstecke das nächste Wort (Token) und rate es anhand des vorigen Textes! Durch diesen simplen Trick erwirbt das Modell ein umfassendes Sprachgefühl, grammatikalische Perfektion und enormes Weltwissen. Das Ergebnis nennt man Basismodell (Base Model).
Die Metapher des ungezogenen Weltenbummlers: Das Basismodell nach dem Pre-Training ist zwar unendlich belesen, aber es taugt noch nicht als hilfreicher Chat-Assistent! Es verhält sich wie ein Weltenbummler, der alle Bibliotheken der Welt auswendig kennt, aber kein Benehmen besitzt. Wenn du ihn fragst: „Was ist die Hauptstadt von Frankreich?“, antwortet er vielleicht nicht mit „Paris“, sondern schreibt stur weiter: „... und was ist die Hauptstadt von Italien? Frage 2 im großen Geografie-Quiz.“ Das Modell glaubt schlicht, es müsse einen beliebigen Text aus dem Internet vervollständigen.
2. Post-Training & Alignment (Die Höflichkeits- und Dialogschule)
In einfacher Sprache: Die Erziehung des Basismodells zum hilfsbereiten, höflichen und sicheren Alltagsassistenten.
Die zweite Trainingsphase, bei der das Basismodell gezielt darauf trainiert wird, Nutzeranweisungen zu befolgen (Instruction Tuning) und menschlichen Werten zu entsprechen (Alignment). Mit Methoden wie RLHF (Reinforcement Learning from Human Feedback) bewerten menschliche Tester und automatisierte Prüfmodelle tausende Antwortvarianten: Welche Antwort war höflich, sachlich und direkt auf den Punkt? Welche war unsicher oder unhöflich? So lernt das Modell, Fragen direkt zu beantworten und schädliche Anfragen (z. B. Bauanleitungen für Schadsoftware) verlässlich abzulehnen.
Erst durch dieses Feintuning wird aus dem unberechenbaren Textgenerator der geduldige, einfühlsame Assistent, den wir heute im Alltag schätzen. Wie du diese Fähigkeiten in Folge 14 mit eigenen Firmendaten weiter vertiefen kannst (Fine-Tuning), erfährst du später im Kurs.
Die Qualität der Daten entscheidet alles: Müll rein, Müll raus
Ein altes Gesetz der Informatik gilt für Künstliche Intelligenz umso schärfer: „Garbage In, Garbage Out“ (GIGO) – wer die KI mit schlechten Daten füttert, erntet fehlerhafte, unsinnige oder schädliche Ergebnisse. Deshalb achten führende KI-Labore heute weit mehr auf die Qualität und Kuration der Daten als auf die bloße Masse.
Bias (Datenverzerrung & Vorurteile)
In einfacher Sprache: Menschliche Vorurteile oder Einseitigkeiten, die unbemerkt in den Trainingsdaten stecken und von der KI wie Fakten nachgeahmt werden.
Eine systematische Verzerrung in den Ergebnissen eines Modells. Da KIs aus historischen Texten und Bildern des Internets lernen, spiegeln sie auch alte Stereotype wider: Wenn in den Trainingsdaten das Wort „Chefarzt“ überwiegend in Kombination mit männlichen Namen und „Pflegekraft“ mit weiblichen Namen vorkam, neigt das Modell dazu, Männer bevorzugt als Ärzte darzustellen. Datenaufbereitung erfordert daher strenge Filterung und bewusste Balance.
Overfitting (Auswendiglernen statt Verstehen)
In einfacher Sprache: Wenn eine KI ihre Trainingsbeispiele stur auswendig lernt, statt allgemeine Prinzipien zu begreifen.
Ein unerwünschter Zustand beim Training, bei dem das Modell die exakten Trainingsdaten perfekt wiedergeben kann, aber bei neuen, leicht veränderten Aufgaben kläglich versagt. Es ähnelt einem Fahrschüler, der nur die Prüfungsstrecke auswendig gelernt hat, aber bei der ersten unvorhergesehenen Baustelle im Nachbarort die Orientierung verliert.
Knowledge Cutoff (Wissensgrenze / Redaktionsschluss)
In einfacher Sprache: Der feste Stichtag, an dem die Trainingsdaten einer KI enden.
Der Zeitpunkt, an dem das Training eines Modells abgeschlossen wurde. Ein fertig trainiertes neuronales Netz ist „eingefroren“ – es lernt im normalen Dialog nicht automatisch mit. Alle Ereignisse, Gesetzesänderungen oder Nachrichten, die sich nach diesem Datum ereignet haben, sind dem Modell von sich aus völlig unbekannt. Um aktuelles Wissen einzubinden, greifen moderne Systeme auf Live-Websuchen oder RAG (Retrieval-Augmented Generation) zurück, wie wir es in Folge 11 vertiefen.
Verwechsle die Dialogfähigkeit einer KI niemals mit einem echten Weltverständnis oder menschlichem Bewusstsein! Das Modell berechnet lediglich statistische Wahrscheinlichkeiten auf Basis seiner Trainingsdaten. Wenn die Daten lückenhaft, veraltet oder verzerrt waren, wird die KI diese Schwächen mit verblüffender Selbstüberzeugung wiederholen – das Phänomen der Halluzination aus Folge 3.
Praxistipp für deinen Alltag
Wenn du dir bei einer Frage nicht sicher bist, ob dein KI-Assistent auf verlässliche Fakten zurückgreifen kann, stelle vorab zwei einfache Testfragen:
- „Was ist dein Knowledge Cutoff bzw. bis zu welchem Monat und Jahr reichen deine Trainingsdaten?“
- „Nutzt du für meine Frage eine Live-Websuche oder antwortest du ausschließlich aus deinem Trainingswissen?“
So vermeidest du veraltete Auskünfte (z. B. bei Fahrplänen, Steuerfreibeträgen oder Software-Updates) und weißt sofort, wann du die Websuche explizit aktivieren solltest.
Pflichtübung: Die Daten-Detektivin
Versetze dich in die Rolle einer Prüferin für KI-Systeme. Lies dir die folgenden drei Alltagsszenarien durch und überlege kurz: Welches Datenproblem liegt hier vor – und wie könnte man es lösen?
- Szenario A (Bewerbungs-Filter): Eine Software-Firma lässt Bewerbungen durch eine KI vorsortieren, die mit den erfolgreichen Neueinstellungen der letzten 15 Jahre trainiert wurde. Auffällig: Weibliche Bewerberinnen erhalten systematisch schlechtere Bewertungen.
- Szenario B (Kundenservice-Bot): Ein Online-Shop setzt einen Chatbot ein, der Beschwerden beantworten soll. Bei Fragen zur neuen Widerrufsfrist von 30 Tagen beharrt der Bot stur darauf, dass Kunden nur 14 Tage Zeit hätten – obwohl die Geschäftsführung die AGB vor zwei Monaten geändert hat.
- Szenario C (Bildgenerierung): Eine Marketingabteilung lässt sich Bilder für eine Broschüre über moderne Berufe generieren. Beim Prompt „Ein Team aus Ingenieuren und Führungskräften bei einer Besprechung“ sind auf allen fünf Bildvarianten ausschließlich weiße Männer im dunklen Anzug zu sehen.
Musterlösung anzeigen (nach dem eigenen Versuch aufklappen)
Auflösung zu Szenario A (Historischer Bias):
Hier liegt ein klassischer historischer Bias vor. Weil in der Vergangenheit überproportional viele Männer eingestellt wurden, hat das Modell gelernt: „Attribut männlich korreliert mit Erfolg“. Lösung: Namen, Geschlechtsangaben und Hobbys vor der Analyse unkenntlich machen und das Modell mit ausgewogenen, anonymisierten Kriterien trainieren.
Auflösung zu Szenario B (Wissensgrenze / Knowledge Cutoff):
Das Modell wurde vor der AGB-Änderung trainiert und hat die alte Frist fest in seinen Parametern gespeichert. Es lernt im Chat nicht automatisch mit. Lösung: Den Bot über RAG (Folge 4 & Folge 11) direkt an die aktuellen Firmen-AGBs anbinden, statt ihn aus dem Gedächtnis raten zu lassen.
Auflösung zu Szenario C (Stereotype in Bilddaten):
Die Bild-KI spiegelt die vorherrschenden Stockfotos und Medienbilder der Vergangenheit wider. Lösung: Den Prompt präzisieren (z. B. „... mit einem diversen Team aus Männern und Frauen unterschiedlicher Herkunft und Altersgruppen“) oder Bildmodelle nutzen, die durch gezieltes Alignment eine ausgewogenere Standardausgabe erzeugen.
Übung für heute
Probiere das Gelernte heute in deinem bevorzugten KI-Chat aus:
- Frage die KI nach ihrem Redaktionsschluss (Knowledge Cutoff) und beobachte, wie präzise sie antwortet.
- Bitte sie, eine typische Alltagsaufgabe zu lösen (z. B. „Schreibe eine kurze E-Mail an die Hausverwaltung wegen eines tropfenden Wasserhahns“). Überlege dir dabei: Welche Schichten der Ausbildung spiegeln sich in der Antwort wider? Das reine Sprachgefühl (Pre-Training) oder die höfliche Anrede und Hilfsbereitschaft (Post-Training/Alignment)?

Wissens-Check: Teste dein Wissen
Nachdem du die Lektion durchgearbeitet und den Deep Dive Podcast gehört hast: Wie gut beherrschst du das Wissen über Daten und Training? Teste dein Wissen in diesem interaktiven Quiz mit 10 Fragen:
Fazit
Künstliche Intelligenz ist weder Zauberei noch ein allwissendes Gehirn – sie ist das mathematische Spiegelbild ihrer Trainingsdaten. Im zweistufigen Prozess lernt sie im Pre-Training zunächst die Struktur und das Wissen der Welt, bevor sie im Post-Training zum höflichen, sicheren Dialogpartner geformt wird. Doch das Fundament bleibt die Datenqualität: Werden veraltete, schiefe oder fehlerhafte Daten eingespeist, erzeugt das Modell Verzerrungen (Bias) und Wissenslücken. Mit diesem Hintergrundwissen begegnest du den Antworten einer KI mit gesundem Urteilsvermögen. In der nächsten Folge schauen wir uns an, wie wir diese Sprachgewalt ganz konkret für uns nutzen: beim Verfassen, Überarbeiten und Strukturieren von Texten.
Weiter geht es mit Folge 6: Texte schreiben mit KI.