Bilder mit KI erzeugen
In den bisherigen Folgen hast du gelernt, wie KI Sprache verarbeitet, wie du Prompts schreibst und wie du Texte mit System erstellst. Doch moderne generative KI beschränkt sich längst nicht mehr auf Worte: Auf Zuruf zaubert sie fotorealistische Porträts, malt stimmungsvolle Gemälde, entwirft Logos oder illustriert ganze Buchseiten. In dieser Folge wechseln wir vom Text zur visuellen Kreativität: Du erfährst, wie Bild-KIs aus Datenpunkten Motive formen, wie du Bildideen präzise formulierst und welche Spielregeln für Transparenz und Urheberrecht gelten.
Du verstehst die physikalisch-mathematischen Grundprinzipien moderner Bild-KIs (vom Diffusionsmodell bis zum modernen Flow Matching). Du beherrschst die vier Bausteine für treffsichere Bild-Prompts, weißt, wie du Texte im Bild renderst, bestehende Bilder per Reverse-Prompting analysierst und Bild-Charaktere über mehrere Szenen hinweg konsistent hältst. Zudem kennst du die rechtlichen Grenzen und die Transparenzstandards (C2PA und EU AI Act).
Wie KI Bilder erschafft: Von Diffusion zu Flow Matching
Wenn du einer KI schreibst: „Ein rotes Holzhaus an einem norwegischen Fjord bei Sonnenuntergang“, sucht sie keineswegs bestehende Fotos im Internet zusammen und schneidet diese wie eine Collage aneinander. Das Bild existierte vor deiner Eingabe nirgendwo auf der Welt – die KI errechnet es von Grund auf neu.
Lange Zeit basierten fast alle Generatoren auf sogenannten Diffusionsmodellen. Stell dir das vor wie einen Bildhauer, der vor einem völlig unförmigen Felsbrocken steht: Die KI beginnt mit einem digitalen „Punktesalat“ – einem Bildschirm voller bunten, zufälligen Rauschens (wie das Flimmern eines alten Fernsehers ohne Sender). Schritt für Schritt schlägt das Modell in 20 bis 50 Rechenschritten jenes Rauschen weg, das nicht zu deiner Textbeschreibung passt, bis das fertige Bild glasklar hervortritt.
Diffusionsmodell (Diffusion Model)
In einfacher Sprache: Wie verwandelt die KI Wörter in ein scharfes Bild?
Ein Bildgenerierungsverfahren, das während des Trainings gelernt hat, wie Bilder schrittweise verrauscht werden – um diesen Prozess bei der Generierung exakt umzukehren: Ausgehend von reinem Zufallsrauschen wird in vielen kleinen Rechenschritten alles Rauschen entfernt, bis ein detailreiches Bild entsteht, das semantisch zu deinem Prompt passt.
Seit 2024 und vor allem heute im Jahr 2026 hat sich die Technologie entscheidend weiterentwickelt: Führende Spitzenmodelle wie FLUX.1 (von den europäischen Black Forest Labs) oder neuere Architekturen nutzen Flow Matching (oft als Rectified Flow umgesetzt). Statt aufwendig in vielen kleinen Zickzack-Schritten zu entrauschen, berechnet das Modell den direkten, geradlinigen Fluss vom Rauschen zur Bildstruktur. Das Ergebnis: Die Bilder werden in einem Bruchteil der Zeit berechnet, Hände und Gliedmaßen wirken anatomisch korrekt und selbst feinste Schriften gelingen gestochen scharf.
Flow Matching
In einfacher Sprache: Der direkte Schienenweg vom Chaos zum fertigen Bild.
Eine moderne mathematische Weiterentwicklung der Bildgenerierung: Anstatt das Rauschen in vielen kleinen Zufallsschritten abzutragen, lernt das Modell ein geradliniges Geschwindigkeitsfeld (einen „Flow“), das die Bildpunkte direkt vom Rauschzustand in die gewünschte Bildkomposition überführt. Das spart enorme Rechenleistung und liefert eine überragende Detailtreue.
(Millionen bunte Pixel ohne Sinn)"] --> B["2. Steuerungsbefehl (Prompt)
(z. B. 'Haus am Fjord, Abendlicht')"] B --> C["3. Schrittweises Entrauschen / Flow Matching
(Grobe Konturen & Lichtachsen formen sich)"] C --> D["4. Feinschliff & Texturaufbau
(Holzmaserung, Wasserwellen, Schatten)"] D --> E["5. Fertiges Kunstwerk
(Gestochen scharf & pixelgenau berechnet)"] style A fill:#f8f9fa,stroke:#e35941 style B fill:#dbe5ff,stroke:#2a4dd0 style C fill:#fff8e8,stroke:#f0a500 style D fill:#f8f9fa,stroke:#3fb950 style E fill:#e8f5e9,stroke:#3fb950
Die vier Bausteine für wirksame Bild-Prompts
Erinnerst du dich an die Prompt-Regeln aus Folge 2? Bei Bildern gilt das Gleiche: Wer nur „Ein gemütliches Zimmer“ eingibt, zwingt die KI zum hemmungslosen Erraten aller Details. Du erhältst ein beliebiges Standard-Stockfoto.
Ein vollständiger, wirkungsvoller Bild-Prompt setzt sich deshalb aus vier zentralen Bausteinen zusammen:
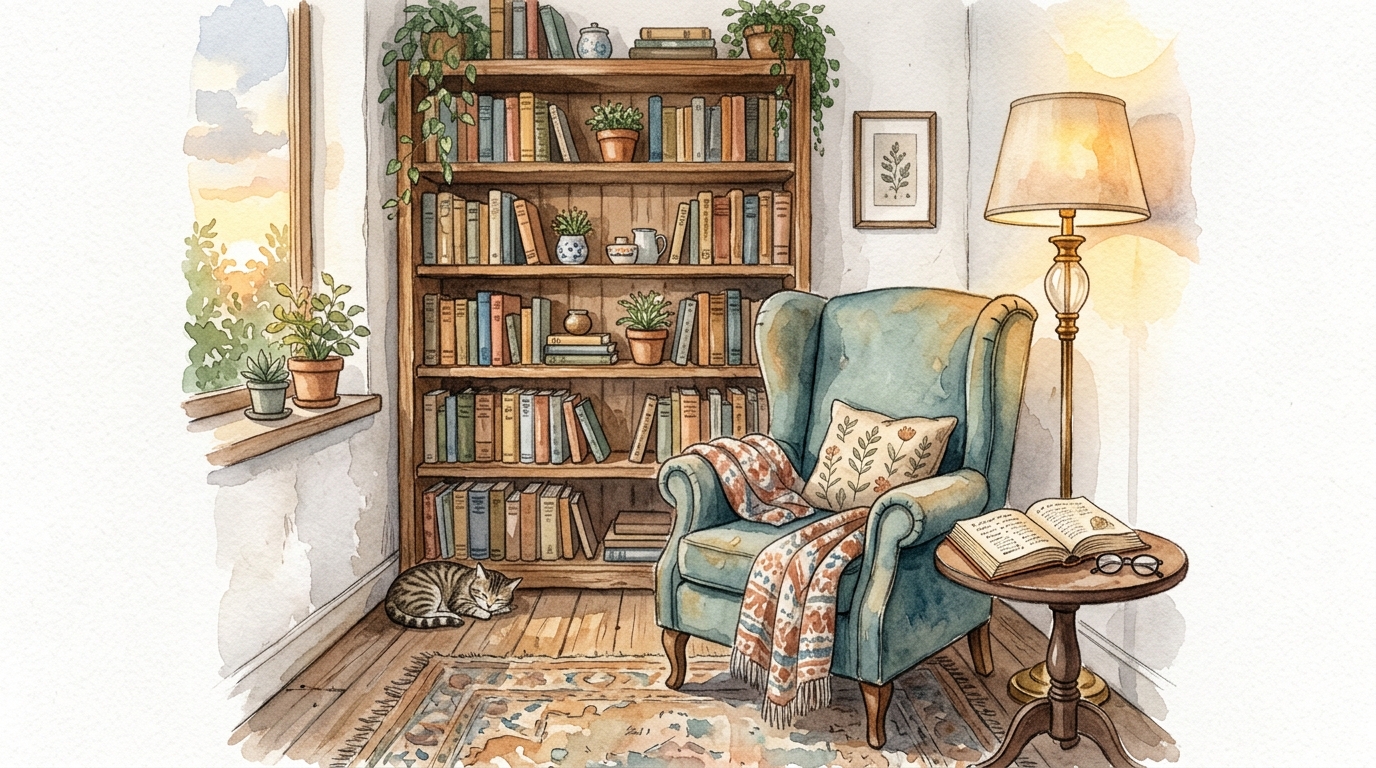
- Das Motiv (Was?): Wer oder was steht im Mittelpunkt der Szene? Welche Handlung oder Beziehung findet statt? (z. B. „Ein gemütlicher Ohrensessel mit gestrickter Wolldecke, daneben ein kleiner runder Beistelltisch aus Holz mit einer dampfenden Teetasse“).
- Der Stil & das Medium (Wie?): Welches künstlerische Werkzeug soll imitiert werden? Ein Schnappschuss mit dem Smartphone, eine professionelle 35mm-Spiegelreflex-Aufnahme, ein sanftes Aquarell, eine Kreidezeichnung oder ein minimalistisches Vektor-Icon?
- Licht & Atmosphäre (Welche Stimmung?): Licht bestimmt die Emotion eines Bildes. Suchst du das weiche Licht der „Goldenen Stunde“ kurz vor Sonnenuntergang, kühles diffuses Morgenlicht, dramatisches Kinolicht (Cinematic Lighting) mit tiefen Schatten oder klinisch sauberes Studio-Licht?
- Komposition & Bildausschnitt (Wie arrangiert?): Aus welcher Perspektive blicken wir auf das Geschehen? Totale (Weitwinkel), frontale Nahaufnahme, Vogelperspektive von oben? Und in welchem Seitenverhältnis soll das Bild ausgegeben werden (z. B.
16:9für Präsentationen und Monitore,1:1für quadratische Posts oder9:16für Smartphone-Stories)?
Beschreibe immer, was ZU SEHEN SEIN SOLL – nicht, was fehlen soll!
Bildmodelle haben keine visuelle Verneinung. Wenn du schreibst: „Ein Frühstückstisch ohne Kaffeetasse“, aktiviert das Wort „Kaffeetasse“ im Modell die entsprechenden Bildmuster – und mit hoher Wahrscheinlichkeit steht mitten auf dem Tisch eine riesige Kaffeetasse. Formuliere stattdessen positiv: „Ein Frühstückstisch, auf dem ausschließlich eine Glasschale mit Müsli und ein Glas frisch gepresster Orangensaft stehen.“
Der Durchbruch: Text und Schriften im Bild
Jahrelang galt die Darstellung von lesbarem Text als die unüberwindbare Achillesferse der Bild-KIs: Straßenschilder, Logos oder Buchtitel glichen unleserlichem Kauderwelsch aus Fantasie-Hieroglyphen. Der Grund: Alte Diffusionsmodelle verstanden zwar grobe Formen, hatten aber kein Sprachmodell „im Bauch“, das die feine Abfolge von Buchstaben beim Entrauschen steuern konnte.
Im Jahr 2026 ist dieses Problem gelöst: Moderne multimodale Generatoren (wie FLUX.1, Ideogram 2/3, Google Imagen 3 und ChatGPT Images) binden moderne Sprachmodelle direkt in den Zeichenprozess ein. Du kannst der KI heute konkrete Wörter in Anführungszeichen mitgeben:
„Ein rustikales Holzschild an einer Berghütte im Wald, auf dem in geschwungener weißer Schrift exakt das Wort ‚Alpenruhe‘ steht.“
Die KI platziert den Schriftzug passgenau, beachtet Lichtreflexe auf den Buchstaben und fügt den Text nahtlos in die Holzmaserung ein.
Visuelle Konsistenz: Derselbe Charakter in vielen Szenen
Eine der häufigsten Herausforderungen für Kreative lautet: „Wie schaffe ich es, dass eine Person in fünf verschiedenen Bildern immer gleich aussieht?“ Wenn du fünfmal „Eine junge blonde Frau mit Brille im Büro“ promptest, erfindet die KI jedes Mal ein völlig anderes Gesicht.
Genau dieses Problem haben wir in unserem Kurs gelöst: Unsere Einsteigerin begleitet dich als durchgängige Protagonistin von Folge 1 bis Folge 16. Um diese visuelle Kontinuität zu wahren, nutzen moderne Workflows drei Methoden:
- Referenzbilder (Image-Prompting / Multi-Modalität): Du übergibst der KI bei jeder neuen Generierung das ursprüngliche Porträt als Bilddatei (wie in unserem Kurs das Titelbild aus Folge 1) und instruierst das Modell: „Nutze das übergebene Referenzbild der Person, um denselben Charakter fotorealistisch in folgender neuer Szene darzustellen...“.
- Image-to-Image (Bild-zu-Bild): Du nimmst ein fertiges Bild und lässt die KI nur Teilbereiche verändern (z. B. Kleidung oder Hintergrund anpassen, während Kopf und Gesichtsausdruck unverändert bleiben).
- Identitäts-Parameter (Seeds & IP-Adapter): Bei fortgeschrittenen Werkzeugen kann man denselben mathematischen Zufallswert (Seed) oder spezielle Identitätsfilter fixieren, damit Gesichtszüge und Proportionen stabil bleiben.
Reverse-Prompting: Aus Bildern neue Prompts zaubern
Hast du im Internet oder in einem Magazin ein faszinierendes Bild gesehen und fragst dich: „Wie müsste der Prompt lauten, um genau diesen Stil oder diesen Lichteinfall mit einer KI nachzubauen?“
Dafür nutzt du den genialen Trick des Reverse-Promptings (umgekehrtes Prompting):
Reverse-Prompting (Bild-zu-Prompt)
In einfacher Sprache: Ein Bild hochladen und sich den passenden Bauplan verraten lassen.
Der Prozess, bei dem du ein bestehendes Bild in einen multimodalen KI-Chat (z. B. ChatGPT, Gemini oder Claude) einspeist und das Modell bittest, die Szene in ihre visuellen Einzelkomponenten (Motiv, Beleuchtung, Kunstrichtung, Farbpalette, Kameraperspektive) zu zerlegen und einen gebrauchsfertigen Text-Prompt daraus zu formulieren.
Die praktische 3-Schritte-Anleitung:
- Lade das Bild in deinen KI-Chatbot über das Büroklammer- oder Bildsymbol hoch.
- Gib folgenden Befehl ein:
„Analysiere dieses Bild. Zerlege es präzise in die 4 Bausteine: Motiv, Stil/Medium, Lichtstimmung und Komposition. Formuliere mir daraus einen detaillierten Text-Prompt auf Deutsch, mit dem ein Bildgenerator ein Werk im exakt selben Stil erzeugen kann.“ - Kopiere den generierten Prompt, tausche das Motiv nach deinen Wünschen aus (z. B. „statt eines Apfels eine Teetasse“) und starte die Generierung.
Marktübersicht: Führende Bild-Generatoren 2026
Für den Einstieg brauchst du weder Photoshop noch teure Spezialhardware. Die führenden Werkzeuge lassen sich bequem im Webbrowser oder über bekannte Chat-Apps ausprobieren:
| Werkzeug / Modell | Entwickler | Herausragende Stärken | Typischer Einsatzbereich |
|---|---|---|---|
| FLUX.1 (Schnell / Dev / Pro) | Black Forest Labs (EU) | Modernes Flow Matching, überragender Fotorealismus, makellose Typografie & Hände, quelloffene Varianten. | Plakate, hochauflösende Fotos, professionelle Illustrationen. |
| Midjourney (v6 / v7) | Midjourney Inc. | Unübertroffenes Gespür für filmische Ästhetik, Lichtstimmungen, Texturen und künstlerischen Ausdruck. | Storyboarding, Buchcover, Konzeptkunst, kreative Porträts. |
| ChatGPT Images (GPT-Image) | OpenAI | Direkt im Chat dialogisch steuerbar; versteht komplexe Anweisungen im Fließtext und rendert sauberen Text. | Alltagsillustrationen, Schaubilder, schnelle Social-Media-Grafiken. |
| Google Gemini (Imagen 3) | Google DeepMind | Rasant schnell, lebendige Farben, tiefe Integration in Workspace und Android, sehr hohe Treffsicherheit. | Präsentationen, Blog-Illustrationen, schnelle Fotomontagen. |
| Adobe Firefly (Image 3 / 4) | Adobe | Rechtlich abgesichert (ausschließlich auf lizenziertem Adobe Stock trainiert), nahtlose Werkzeuge in Photoshop. | Kommerzielle Werbung, Corporate Design, Agentur-Workflows. |
| Ideogram (v2 / v3) | Ideogram AI | Der Spezialist für Text-in-Bild, T-Shirt-Designs, Typografie-Plakate und grafische Layouts. | Marketing-Banner, Flyer, T-Shirt-Prints, Logodesign. |
Kosten, Nutzungslimits und Inhaltsfilter
Wenn du anfängst, intensiver mit Bildgeneratoren zu arbeiten, wirst du schnell auf praktische Grenzen stoßen:
- Freemium & monatliche Kontingente: Viele Plattformen (wie Microsoft Designer, Google Gemini oder Canva) stellen kostenlose Basiskontingente bereit. Bei professionelleren Anbietern (Midjourney, Adobe) bezahlst du monatliche Abos oder kaufst Rechen-Credits („Fast Hours“).
- Inhaltsfilter (Guardrails): Cloud-Dienste lehnen Prompts rigoros ab, wenn sie gegen Schutzrichtlinien verstoßen. Dazu gehören Gewalt, Pornografie (NSFW), Hassrede, das unbefugte Generieren bekannter Prominenter oder geschützte Markenlogos.
- Cloud vs. Lokal (ComfyUI & Open Weights): Modelle wie FLUX oder Stable Diffusion lassen sich mit Software wie ComfyUI auch völlig kostenfrei und zensurfrei auf der eigenen Grafikkarte ausführen. Dies erfordert jedoch leistungsfähige Hardware (min. 8–16 GB Grafikspeicher) und überträgt die volle ethische und rechtliche Verantwortung für den erzeugten Inhalt allein auf dich.
Recht, Urheberrecht und Transparenz nach EU AI Act
Weil KI-Bilder heute oft nicht mehr mit bloßem Auge von echten Fotos unterschieden werden können, hat der Gesetzgeber klare Leitplanken eingezogen. Folgende Grundregeln solltest du im Alltag kennen (Hinweis: Dies stellt keine Rechtsberatung dar):
1. Kein Urheberrechtsschutz für reine KI-Bilder:
Nach deutschem und europäischem Urheberrecht können nur Werke geschützt werden, die das Ergebnis einer persönlichen geistigen Schöpfung eines Menschen sind. Ein Bild, das durch das Eintippen eines Prompts von einer Maschine berechnet wurde, besitzt keine menschliche Schöpfungshöhe. Du besitzt daran in der Regel kein exklusives Urheberrecht – andere Personen dürfen es rechtlich gesehen grundsätzlich kopieren und weiternutzen.
2. Marken- und Persönlichkeitsrechte beachten:
Auch wenn du kein Urheberrecht besitzt, haftest du voll für Rechtsverletzungen! Wer das Gesicht einer realen Nachbarin, eines Kollegen oder eines Prominenten ohne deren Einwilligung fotorealistisch generiert, verletzt deren Recht am eigenen Bild. Ebenso ist das Erzeugen geschützter Markenlogos oder Comicfiguren (z. B. Disney-Figuren) für geschäftliche Zwecke abmahnfähig.
3. Kennzeichnungspflicht nach dem EU AI Act (ab August 2026):
Künstlich erzeugte Bilder und Videos, die reale Personen oder tatsächliche Ereignisse vortäuschen könnten (Deepfakes) oder der öffentlichen Information dienen, müssen unmissverständlich als KI-generiert gekennzeichnet werden. Wer solche Bilder ohne Hinweis veröffentlicht, begeht einen Gesetzesverstoß.
C2PA (Content Credentials & Bildpass)
In einfacher Sprache: Der fälschungssichere digitale Reisepass eines Fotos.
Ein offener Industriestandard (Coalition for Content Provenance and Authenticity), der kryptografisch gesicherte Metadaten direkt in die Bilddatei einbettet. Er dokumentiert lückenlos, mit welcher Software, welchem Modell und wann ein Bild erstellt oder bearbeitet wurde. Ergänzt wird dies durch unsichtbare pixelbasierte Wasserzeichen (wie SynthID), die selbst nach Screenshots oder Zuschneiden maschinell nachweisbar bleiben.
Pflichtübung: Die Bild-Prompt-Detektivin
Stell dir vor, du planst einen Flyer für ein kleines Nachbarschaftscafé und möchtest ein warmes, einladendes Foto für die Titelseite erstellen. Ein Bekannter schlägt dir folgenden Prompt vor:
„Ein schönes Café mit Kaffee und Kuchen auf dem Tisch.“
Deine Aufgabe: Dieser Prompt ist viel zu vage und überlässt alles dem Zufall. Wende die 4-Bausteine-Formel (Motiv, Stil/Medium, Licht/Stimmung, Komposition) an, binde das Prinzip des positiven Promptings ein und formuliere einen professionellen, fotorealistischen Bild-Prompt auf Deutsch.
Musterlösung anzeigen (nach dem eigenen Versuch aufklappen)
Schritt 1: Analyse der Schwachstellen:
- Motiv: Welcher Kuchen? Welche Tasse? Wie sieht der Tisch aus?
- Stil: Foto oder Zeichnung? Welche Kameraqualität?
- Licht: Dunkel, grell oder sonnig?
- Komposition: Welches Format? Welche Perspektive?
Schritt 2: Der verbesserte 4-Bausteine-Prompt:
„Fotorealistisches Bild im Querformat 16:9. Auf einem rustikalen Holztisch an einem großen Café-Fenster steht eine weiße Keramiktasse mit cremigem Cappuccino und kunstvoller Milchschaum-Blume (Latte Art). Daneben liegt auf einem kleinen Teller ein frisches Stück Karottenkuchen mit Walnüssen. Im Hintergrund ist der gemütliche, unscharfe Innenraum des Cafés mit Bücherregalen und warmen Hängelampen zu sehen. Warmes, weiches Sonnenlicht fällt von der Seite durch die Scheibe und erzeugt sanfte Schatten. Gestochen scharfe Makroaufnahme, ruhige und einladende Atmosphäre, natürliche Farben.“
Erkenntnis: Durch die präzisen Vorgaben weiß die Bild-KI exakt, wo die Schärfentiefe liegen soll, welches Licht gewünscht ist und wie die Szene emotional wirken soll.
Übung für heute
Werde heute selbst visuell aktiv – ganz ohne Zeichenstift:
- Öffne einen kostenlosen Bildgenerator (z. B. Microsoft Copilot / Designer, ChatGPT, Google Gemini oder Canva Magic Media).
- Erstelle dein erstes Bild nach der 4-Bausteine-Formel: Wähle ein Motiv deines Alltags (deinen Traum-Schreibtisch, deinen Garten oder ein Haustier) und experimentiere mit zwei völlig unterschiedlichen Stilen (z. B. zuerst „Fotorealistisch mit 35mm-Objektiv“, danach „Im Stil einer bunten Pop-Art-Grafik“).
- Probiere anschließend Reverse-Prompting aus: Lade ein Foto aus deinem Smartphone in den Chatbot hoch und lass dir den Prompt-Bauplan aufschlüsseln!

Wissens-Check: Teste dein Wissen
Nachdem du die Lektion durchgearbeitet und den Deep Dive Podcast gehört hast: Wie gut beherrschst du die Bildgenerierung, Flow Matching, Prompt-Bausteine und Transparenzregeln? Teste dein Wissen in diesem interaktiven Quiz mit 10 Fragen:
Fazit
Bilder mit generativer KI zu erschaffen, erfordert kein zeichnerisches Können, sondern die Fähigkeit, visuelle Ideen präzise in Worte zu fassen. Moderne Modelle wie FLUX.1, Midjourney oder ChatGPT Images beherrschen dank Flow Matching heute fotorealistische Details, korrekte Anatomie und sogar lesbare Schriften. Mit den vier Bausteinen (Motiv, Stil, Licht, Komposition) nimmst du das Steuer fest in die Hand. Achte auf das positive Formulieren, nutze Reverse-Prompting als Inspirationsquelle und beachte stets die Transparenzregeln und das Urheberrecht. In der nächsten Folge verlassen wir die visuelle Welt und bringen die KI zum Klingen: bei Sprache, Musik und Podcasts.
Weiter geht es mit Folge 8: Audio, Musik und Podcasts mit KI.